

Data Platforms et Data Gouvernance : Le Socle Stratégique de la Transformation Numérique
À l’ère de la donnée omniprésente, les entreprises font face à un défi majeur : transformer leurs volumes croissants d’informations en avantages concurrentiels durables. Au cœur de cette transformation se trouvent les data platforms, des écosystèmes technologiques sophistiqués qui orchestrent la collecte, le traitement, le stockage et l’analyse des données à grande échelle. Ces infrastructures, loin d’être de simples outils techniques, constituent désormais le système nerveux central des organisations modernes, alimentant l’intelligence artificielle, optimisant les processus métier et accélérant la prise de décision stratégique.
Netflix illustre parfaitement cette transformation : la plateforme économise plus d’un milliard de dollars annuellement grâce à sa data platform sophistiquée. Son système de recommandation, alimenté par 15 millions d’événements par seconde traités en temps réel, génère plus de 80% de l’activité de visionnage. Cette capacité de personnalisation massive, rendue possible par une architecture data moderne, lui permet de maintenir un taux de rétention client de 93%, largement supérieur à ses concurrents.
Amazon démontre également la puissance stratégique des data platforms avec AWS qui a généré 108 milliards de dollars de revenus en 2024, soit une croissance de 19% année sur année. Les systèmes de recommandation d’Amazon, alimentés par leur infrastructure data, génèrent 35% des ventes de la plateforme, transformant les données en avantage concurrentiel direct.
L'Écosystème des Data Platforms : Architecture et Composants Essentiels
Définition et Périmètre Fonctionnel
Une data platform est un ensemble intégré de solutions permettant de collecter, stocker, transformer, analyser et gouverner des données issues de sources multiples (ERP, IoT, applications métier, réseaux sociaux, etc.). Elle s’articule autour de plusieurs couches :
- Ingestion : collecte automatisée de données hétérogènes
- Stockage scalable : data lake, data warehouse, lakehouse
- Transformation : pipelines ETL/ELT, traitements batch ou temps réel
- Exploitation : outils d’analytique, BI, IA, visualisation
- Gouvernance et sécurité : gestion des accès, conformité, traçabilité
La tendance actuelle privilégie des architectures cloud natives, modulaires et interopérables, qui favorisent l’agilité et l’innovation.
Success Stories et Cas d'Usage Concrets
Airbnb a révolutionné sa gestion des données en développant « Dataportal », un outil interne de démocratisation des données qui a éliminé les silos départementaux et favorisé une culture data-driven à l’échelle de l’organisation. Cette transformation a permis une prise de décision plus rapide et cohérente.
Coca-Cola a implémenté une stratégie data robuste alignée sur ses objectifs business, permettant des campagnes marketing plus efficaces et une meilleure compréhension du comportement client, se traduisant par un ROI accru.
Dans le secteur financier, une banque privée leader a modernisé sa plateforme data en 9 mois, consolidant 10 systèmes ERP différents et permettant une génération de rapports financiers globaux réduite d’une semaine à quelques heures.
Data Gouvernance : Définition et Enjeux
La data gouvernance désigne l’ensemble des pratiques, politiques et technologies qui encadrent la gestion, la qualité, la sécurité et la conformité des données tout au long de leur cycle de vie. Elle va bien au-delà du simple data management : il s’agit d’un cadre stratégique qui définit :
- Les normes et standards de gestion des données
- Les rôles et responsabilités (data owner, data steward, CDO)
- Les processus de contrôle (qualité, accès, conformité)
- La gestion du cycle de vie (de la collecte à la suppression)
L'Impact Financier de la Gouvernance
Les coûts de la mauvaise qualité des données sont considérables : selon Gartner, les organisations perdent en moyenne 12,9 millions de dollars annuellement à cause de données de mauvaise qualité. Aux États-Unis, l’impact total atteint 3,1 trillions de dollars par an pour l’économie.
Les statistiques sont alarmantes :
- 95% des organisations reconnaissent que les problèmes de qualité des données impactent directement leurs décisions business
- 60% des analystes passent plus de 60% de leur temps à nettoyer et préparer les données
- 47% des nouvelles données contiennent au moins une erreur critique
- 70% des données d’entreprise sont estimées « sales » ou non fiables
Pourquoi la gouvernance est-elle cruciale ?
- Qualité et fiabilité : Garantir des données exactes, complètes et cohérentes pour des analyses pertinentes
- Sécurité et conformité : Répondre aux exigences réglementaires (RGPD, CCPA) et limiter les risques de violation
- Optimisation des processus : Fluidifier l’accès aux données, réduire les silos et accélérer la prise de décision
- Création de valeur : Permettre l’innovation, la personnalisation client et de nouveaux business models
Sans gouvernance, la donnée devient un frein plutôt qu’un levier : erreurs, incohérences, risques juridiques et perte de confiance métier.
ROI de la Gouvernance des Données
Les organisations avec des programmes de gouvernance matures observent des retours sur investissement significatifs :
- 20-30% d’amélioration dans la prise de décision
- 65% des organisations voient un ROI mesurable dans les 12 mois
- Réduction de 25-40% des erreurs de données
- Économies de conformité pouvant atteindre 2 millions de dollars annuels pour éviter les amendes
Les Piliers Technologiques du Modern Data Stack
Le Modern Data Stack (MDS) repose sur des technologies cloud-natives, modulaires et interopérables. Contrairement aux architectures monolithiques traditionnelles, cette approche favorise la composition de solutions spécialisées qui excellent dans leur domaine respectif tout en s’intégrant harmonieusement avec l’écosystème global.
Infrastructure Cloud et Évolutions du Marché
Les plateformes cloud (AWS, Azure, GCP) fournissent l’infrastructure élastique nécessaire, tandis que des solutions comme Apache Spark orchestrent le traitement distribué des données massives. Les formats de stockage ouverts (Parquet, Delta Lake, Apache Iceberg) garantissent l’interopérabilité et réduisent les risques de dépendance technologique.
Le marché connaît une croissance exceptionnelle avec des projections impressionnantes pour les prochaines années :
Segment | Valeur 2024 (Milliards USD) | Valeur 2025 (Milliards USD) | Valeur projetée 2030-2033 (Milliards USD) | TCAC (%) | Année de projection |
Global Big Data Platform | 73.8 | 80.81 | 168.41 | 9.5 | 2033 |
Autonomous Data Platform | 1.77 | 2.14 | 12.18 | 21.3 | 2034 |
Customer Data Platform | 2.65 | 3.28 | 12.96 | 21.7 | 2032 |
Data Mesh Market | 1.2 | 1.39 | 2.5 | 16.4 | 2028 |
Data Marketplace Platform | 1.46 | 1.77 | 8.38 | 21.4 | 2033 |
Edge Computing Platform | 8.5 | 9.8 | 25.2 | 19.2 | 2030 |
Privacy-Enhancing Technologies | 2.1 | 2.5 | 15.8 | 38.5 | 2030 |
Cette croissance soutenue, avec un TCAC moyen de 21,1%, reflète l’adoption massive des technologies data et l’émergence de nouveaux paradigmes comme le Data Mesh et l’Edge Computing.
Technologies Émergentes
Edge Computing transforme le traitement des données en les rapprochant de leur source. D’ici 2025, 75% des données enterprise seront traitées en edge, réduisant la latence et optimisant la bande passante pour des applications critiques comme l’IoT industriel et les véhicules autonomes.
Privacy-Enhancing Technologies (PETs) répondent aux enjeux réglementaires croissants avec des techniques comme la computation homomorphique, le differential privacy et le federated learning. Ces technologies permettent d’analyser des données sensibles sans les exposer, ouvrant de nouveaux cas d’usage tout en garantissant la conformité.
Benchmark des Technologies Clés : Choix Stratégiques et Implications
Ingestion de Données : Fivetran vs Airbyte
Le choix de la solution d’ingestion constitue souvent le premier arbitrage stratégique d’un projet de data platform. Fivetran s’impose comme la référence pour les grandes entreprises exigeant des SLA stricts et une automatisation complète. Avec plus de 500 connecteurs certifiés, cette solution propriétaire garantit une fiabilité éprouvée mais impose un coût significatif et un risque de dépendance élevé.
Airbyte, solution open source en forte croissance, propose une alternative séduisante avec plus de 600 connecteurs évolutifs et des coûts réduits de 60 à 80% par rapport aux solutions propriétaires. Cette flexibilité s’accompagne toutefois d’une responsabilité accrue en matière de maintenance et de support technique, particulièrement adaptée aux équipes disposant de compétences DevOps solides.
Technologie | Domaine | Type | Points forts principaux | Risques de vendor lock-in | Technologie |
Fivetran | Ingestion | Propriétaire | Automatisation, connecteurs nombreux, fiabilité | Élevé | Fivetran |
Airbyte | Ingestion | Open source | Flexibilité, coût réduit, communauté active | Faible | Airbyte |
dbt | Transformation | Open source | Modélisation SQL, versioning, documentation | Très faible | dbt |
Dataform | Transformation | Hybride | Intégration Google Cloud, interface simple | Modéré | Dataform |
Databricks | Lakehouse/Analytics | Hybride | Unification data lake/warehouse, IA intégrée | Modéré | Databricks |
Snowflake | Data warehouse | Propriétaire | Simplicité, performance, séparation stockage/calcul | Élevé | Snowflake |
Apache Spark | Traitement distribué | Open source | Scalabilité, standard industriel, multi-cloud | Très faible | Apache Spark |
Collibra | Gouvernance | Propriétaire | Data catalog, workflow, conformité RGPD | Modéré | Collibra |
Alation | Gouvernance | Propriétaire | Data catalog, collaboration, automatisation | Modéré | Alation |
Apache Atlas | Gouvernance | Open source | Data lineage, classification, intégration Hadoop/Spark | Faible | Apache Atlas |
Talend Data Fabric | Gouvernance/Qualité | Hybride | Qualité, intégration, conformité | Modéré | Talend Data Fabric |
Transformation : dbt vs Dataform
Dans l’écosystème de transformation des données, dbt (data build tool) s’est établi comme le standard de facto grâce à son approche open source, sa forte communauté et ses capacités de versioning avancées. Son modèle déclaratif en SQL permet aux équipes data de développer des pipelines maintenables et documentés, réduisant considérablement la dette technique.
Dataform, rachetée par Google et intégrée à Google Cloud, offre une interface web simplifiée et une intégration native avec l’écosystème Google, mais limite la portabilité et introduit un risque de dépendance modéré.
Plateformes Analytiques : Databricks vs Snowflake
L’opposition entre Databricks et Snowflake illustre parfaitement les enjeux architecturaux contemporains. Databricks, avec son architecture lakehouse, unifie les capacités des data lakes et data warehouses tout en intégrant nativement les fonctionnalités de machine learning et d’intelligence artificielle.
Snowflake excelle dans la simplification du data warehousing traditionnel avec sa séparation élégante entre stockage et calcul, ses performances SQL exceptionnelles et sa facilité d’utilisation. Cette solution propriétaire convient aux équipes privilégiant la simplicité opérationnelle mais impose un risque de vendor lock-in élevé.
La Réalité des Défis : Pourquoi 85% des Projets Échouent
Statistiques Alarmantes de l'Industrie
Les données sectorielles révèlent une réalité préoccupante : 85% des projets d’analytics et d’IA échouent, selon les estimations de Gartner. Cette statistique reflète la complexité intrinsèque des projets de data platform et l’insuffisance des approches traditionnelles de gestion de projet technologique.
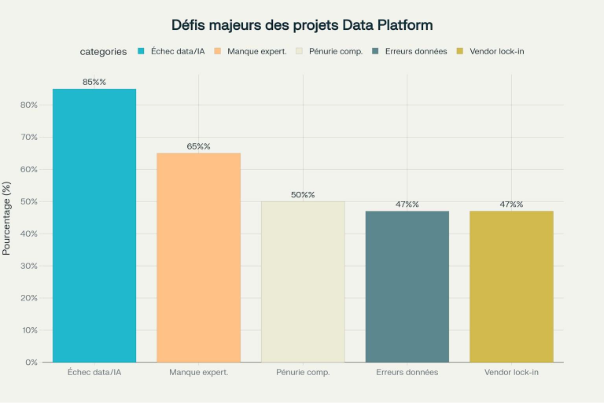
Les causes d’échec s’articulent autour de plusieurs facteurs critiques :
- 65% des projets souffrent d’un manque d’expertise métier
- 50% font face à des pénuries de compétences techniques
- 47% des organisations luttent contre les problèmes de qualité des données
- 52% rencontrent des défis de sécurité et confidentialité
- 45% sont impactés par des contraintes budgé
Vendor Lock-in : Un Risque Sous-estimé
Le vendor lock-in représente un défi stratégique majeur, affectant 47% des organisations selon IDG. Ce phénomène de dépendance technologique peut considérablement limiter la flexibilité future et augmenter les coûts de migration.
L’adoption de standards ouverts (Apache Iceberg, Delta Lake, formats Parquet) et de solutions open source constitue une stratégie de mitigation efficace. Cette approche permet de préserver la portabilité des données et des applications tout en maintenant la flexibilité architecturale nécessaire.
Coûts de Non-Conformité
Les coûts de non-conformité dépassent largement ceux de la mise en conformité :
- Non-conformité : jusqu’à 14,82 millions de dollars annuels
- Conformité : en moyenne 5,47 millions de dollars annuels
- Ratio : la non-conformité coûte 2,71 fois plus cher que la conformité
L'Impératif du Recrutement d'Experts : Une Nécessité Stratégique
La Crise des Talents Data Engineering
L’industrie fait face à une crise sans précédent de talents en data engineering. La croissance explosive de la demande (+122% entre 2013 et 2015 selon Stitch/Galvanize) contraste dramatiquement avec l’offre limitée de professionnels qualifiés.
Les salaires reflètent cette tension :
- Data Platform Engineer : salaire médian de 165,780 USD aux États-Unis
- Data Engineer junior : 42,000 à 55,000 euros en France
- Data Engineer confirmé : 55,000 à 75,000 euros en France
- Expert Data Platform : 70,000 à 120,000 euros en France
Structure d’Équipe Optimale
Une équipe data platform efficace comprend 3 à 8 personnes pour maintenir l’agilité. Au-delà de 8 personnes, il devient nécessaire de subdiviser en équipes spécialisées. Les rôles clés incluent :
- Data Engineers et Analytics Engineers pour le développement
- Platform Engineers pour l’infrastructure cloud
- Data Architect pour la vision d’ensemble
- Product Manager data platform pour l’alignement business
Analyse Économique : Coûts et Bénéfices
Structure des Coûts Projet
L’investissement dans une data platform varie considérablement selon le périmètre et la complexité :

Les coûts de service (conseil, intégration, formation) représentent souvent 50 à 70% du budget total, soulignant l’importance de l’expertise humaine dans ces projets.
ROI et Bénéfices Démontrés
Les organisations avec des data platforms matures observent des bénéfices mesurables :
Croissance de revenus :
- 2,9 fois plus de croissance de revenus pour les entreprises data-driven
- 9,1 fois plus de satisfaction client
- 20% d’augmentation des ventes e-commerce grâce à la personnalisation
Efficacité opérationnelle :
- 10x amélioration de la productivité des équipes data (Group 1001)
- Réduction de 3 mois à 2 jours pour passer de l’idée à l’insight
- 100,000$ d’économies tout en activant des initiatives GenAI (HubSpot)
Coûts de Conformité GDPR
La mise en conformité GDPR représente un investissement significatif mais nécessaire :
- Coût total : 20,500 à 102,500 USD selon la taille de l’organisation
- Consultant fees : 5,000 à 15,000 USD
- Outils de sécurité : 5,000 à 20,000 USD
- Formation : 500 à 20,500 USD
Stratégies de Mitigation des Risques
Approche Méthodologique
La réussite d’un projet de data platform repose sur une méthodologie rigoureuse privilégiant l’approche incrémentale. Plutôt que de viser une plateforme complète dès le départ, il convient de développer des MVP (Minimum Viable Product) focalisés sur des cas d’usage prioritaires et à forte valeur ajoutée.
Cette approche permet de :
- Valider les choix technologiques progressivement
- Former les équipes de manière itérative
- Démontrer la valeur business rapidement
- Réduire les risques d’inadéquation technique-métier
Gouvernance et Qualité des Données
La mise en place d’un framework de gouvernance constitue un prérequis à la réussite. Ce framework doit adresser :
- Qualité des données : 47% des nouvelles données contiennent des erreurs critiques
- Conformité réglementaire : RGPD, sectorielles
- Traçabilité des transformations et accès
L’investissement dans la gouvernance conditionne la fiabilité et la pérennité de l’ensemble de la plateforme.
Technologies Émergentes et Perspectives d'Évolution
Vers des Architectures Data Mesh
L’émergence du paradigme Data Mesh redéfinit l’approche traditionnelle des data platforms en privilégiant une architecture décentralisée où chaque domaine métier gère ses propres données comme des produits. Cette évolution répond aux limites des architectures centralisées face à la complexité croissante des organisations.
Le marché du Data Mesh affiche une croissance de 16,4% CAGR, atteignant 2,5 milliards USD d’ici 2028. Les tendances clés incluent :
- Adoption d’architectures Data Mesh décentralisées
- Intégration AI et Machine Learning
- Traitement des données en temps réel
- Focus sur la gouvernance et la conformité
Intelligence Artificielle et Automation
L’intégration croissante de l’IA dans les pipelines de données transforme les pratiques d’ingénierie :
- Automated data discovery pour l’identification automatique des sources
- Intelligent data quality avec détection automatique d’anomalies
- Self-healing systems pour la correction automatique d’erreurs
Edge Computing et Traitement Décentralisé
L’Edge Computing révolutionne le traitement des données avec des bénéfices concrets :
- Réduction de latence pour les applications temps réel
- Optimisation de bande passante pour l’IoT industriel
- Traitement local pour les données sensibles
Le marché de l’Edge Computing atteindra 25,2 milliards USD d’ici 2030 avec un CAGR de 19,2%.
Privacy-Enhancing Technologies (PETs)
Les PETs émergent comme technologies critiques pour 2024 selon le World Economic Forum :
- Homomorphic encryption pour le calcul sur données chiffrées
- Differential privacy pour l’anonymisation statistique
- Federated learning pour l’apprentissage décentralisé
- Secure multi-party computation pour les analyses collaboratives
Ces technologies permettent d’exploiter la valeur des données tout en respectant la privacy, avec un marché projeté à 15,8 milliards USD d’ici 2030.
Conclusion : L'Investissement Stratégique Incontournable
Les data platforms représentent aujourd’hui un investissement stratégique incontournable pour toute organisation aspirant à tirer parti de ses données. La complexité technique, les enjeux de gouvernance et la criticité business de ces projets rendent l’expertise spécialisée non plus optionnelle, mais absolument essentielle.
Les statistiques sectorielles sont sans appel :
- 85% d’échec sans expertise appropriée
- ROI mesurable en 6 à 18 mois avec accompagnement expert
- 2,9 fois plus de croissance de revenus pour les entreprises data-driven
- Marché en croissance de 21% CAGR sur les prochaines années
Cette dichotomie illustre parfaitement l’enjeu du recrutement d’experts en data platform. Il ne s’agit plus d’un coût, mais d’un investissement de mitigation des risques et d’accélération de la création de valeur.
L’évolution technologique s’accélère avec l’émergence de l’IA native, du Data Mesh, de l’Edge Computing et des Privacy-Enhancing Technologies. Ces innovations exigent une expertise pointue pour être maîtrisées et exploitées efficacement.
Pour les équipes techniques, le recrutement d’un expert data platform offre l’opportunité d’acquérir des compétences de pointe, de travailler sur des technologies d’avant-garde et de contribuer directement à la transformation digitale de l’entreprise. C’est aussi la garantie de mener des projets techniquement stimulants avec de réelles chances de succès et un impact business mesurable.
Dans un contexte où la donnée devient le nouveau pétrole de l’économie numérique, ne pas investir dans l’expertise data platform revient à accepter de rester spectateur de la transformation en cours. Les entreprises qui font ce choix aujourd’hui construisent les fondations de leur avantage concurrentiel de demain.